
tf-idf چیست؟ | بررسی ساختار و کاربرد آن در سئو محتوا
4 دقیقه
در سالهای ابتدایی توسعه وب، الگوریتمهای موتورهای جستجو برای رتبهبندی صفحات به یک معیار بسیار ساده و آسیبپذیر متکی بودند: «چگالی کلمات کلیدی» (Keyword Density). در آن دوران، اگر کلمه کلیدی هدف را به دفعات مکرر در متن تکرار میکردید، موتور جستجو تصور میکرد که محتوای شما کاملاً مرتبط است. اما این ساختار خطی، منجر به تولید محتواهای بیکیفیت و اسپم شد.
برای رفع این نقص سیستماتیک، مهندسان بازیابی اطلاعات (Information Retrieval) به سمت فرمولهای ریاضی و آماری حرکت کردند تا بتوانند «اهمیت واقعی» یک کلمه را در یک متن تشخیص دهند. یکی از مهمترین و پایهایترین این فرمولها، الگوریتم TF-IDF است. در این مقاله تخصصی از رایاپارس، با رویکردی دادهمحور بررسی میکنیم که tf-idf چیست، اجزای تشکیلدهنده این فرمول چگونه محاسبه میشوند و موتورهای جستجو چگونه از آن برای پردازش زبان طبیعی استفاده میکنند.
tf-idf چیست؟
عبارت TF-IDF مخفف Term Frequency-Inverse Document Frequency (فراوانی ترم - فراوانی معکوس سند) است. از منظر علوم داده، این یک الگوریتم آماری است که نشان میدهد یک کلمه (Term) خاص، تا چه اندازه برای یک سندِ مشخص در میان مجموعهای عظیم از اسناد (Corpus یا پیکره متنی) اهمیت دارد.
برخلاف چگالی کلمات کلیدی که فقط به تعداد تکرار یک کلمه در یک صفحه نگاه میکند، الگوریتم TF-IDF ارزش کلمات را وزندهی (Weighting) میکند. در این معماری، کلماتی که در یک مقاله زیاد تکرار شدهاند اما در سایر مقالات وب به ندرت یافت میشوند، وزن و ارزش بسیار بالایی دریافت میکنند؛ زیرا نشاندهنده موضوعِ تخصصیِ آن مقاله خاص هستند.
تحلیل لایهها و اجزای تشکیلدهنده فرمول tf-idf
برای درک اینکه این الگوریتم چگونه کلمات ارزشمند را از کلمات بیارزش تفکیک میکند، باید دو بخش اصلی این فرمول ریاضی را بررسی کنیم:
۱. شاخص TF (Term Frequency - فراوانی عبارت)
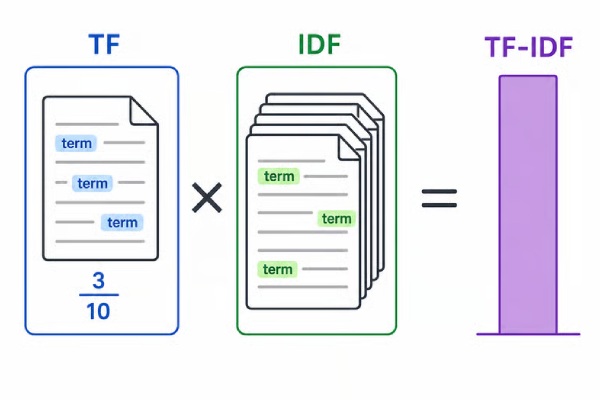
این بخش محاسبه میکند که یک کلمه مشخص، چند بار در یک سند (مقاله) تکرار شده است. منطق پایه این است که هرچه یک کلمه بیشتر در متنی تکرار شود، احتمالاً آن متن بیشتر به آن کلمه مرتبط است.
با این حال، یک مشکل بزرگ وجود دارد: حروف اضافه و ربط مانند «از»، «به»، «در» و «است» در تمام متون فارسی بیشترین تکرار را دارند. اگر فقط به شاخص TF اتکا کنیم، موتور جستجو تصور میکند که موضوع اصلی مقاله شما درباره کلمه «در» یا «است» میباشد! اینجاست که لایه دوم وارد عمل میشود.
 ۲. شاخص IDF (Inverse Document Frequency - فراوانی معکوس سند)
این بخش وظیفه دارد ارزش کلمات رایج و عمومی را کاهش (جریمه) و ارزش کلمات تخصصی و نادر را افزایش دهد. شاخص IDF بررسی میکند که یک کلمه مشخص، در کُلِ اسناد موجود در پایگاه داده (مثلاً کل صفحات ایندکس شده در گوگل) چقدر رایج است.
کلماتی مانند «است» یا «که» در میلیونها سند وجود دارند، بنابراین نمره IDF آنها به شدت به صفر نزدیک میشود. اما کلمهای تخصصی مانند «کلاسترینگ» فقط در اسناد خاصی وجود دارد، بنابراین نمره IDF بالایی دریافت میکند.
- نتیجه ترکیب: با ضرب کردن TF در IDF، کلمات پرکاربردِ بیارزش خنثی شده و کلماتی که موضوعِ اصلیِ متن را تشکیل میدهند، با بالاترین امتیاز استخراج میشوند.
- بررسی ساختار: تفاوت چگالی کلمات (Keyword Density) با TF-IDF
تفاوت این دو مفهوم، تفاوت میان سئوی کلاهسیاه/سنتی و سئوی مدرن است:
- چگالی کلمات کلیدی: یک نسبت درصدِ ساده است (مثلاً کلمه هدف ۳ درصد کل متن را تشکیل دهد). این روش هیچ درکی از زبان، کلمات مترادف یا ارزش معنایی کلمات ندارد.
- معماری TF-IDF: یک سیستم وزندهیِ رابطهای است. این الگوریتم به موتور جستجو میگوید که برای اثبات تخصص در یک زمینه، نیازی به تکرار کورکورانه یک کلمه نیست؛ بلکه باید از کلماتی استفاده کنید که از نظر آماری، در متون تخصصیِ آن حوزه حضور پررنگی دارند (کلمات کلیدی LSI و مفاهیم مرتبط).
بیشتر بخوانید: NLP چیست؟
کاربرد این الگوریتم در سئو و پردازش زبان طبیعی (NLP)
اگرچه گوگل امروزه از شبکههای عصبی و هوش مصنوعی پیشرفته (مانند الگوریتم BERT و MUM) برای درک متون استفاده میکند، اما منطقِ پایه TF-IDF همچنان به عنوان یک لایه پردازشی در موتورهای جستجو و ابزارهای سئو کاربرد دارد:
- تشخیص موضوع اصلی صفحه: گوگل با محاسبه TF-IDF در کسری از ثانیه متوجه میشود که موضوعِ غالب و هسته معنایی (Entity) یک مقاله چیست.
- استخراج کلمات مرتبط (LSI): ابزارهای پیشرفته سئو محتوا با استفاده از این فرمول، مقالات رقبای برتر را آنالیز کرده و به شما میگویند که «برای پوشش کامل این موضوع، باید کلماتی نظیر X و Y را نیز در متن خود استفاده کنید»، زیرا این کلمات در اسناد برتر دارای وزن TF-IDF بالایی هستند.
- جلوگیری از کیورد استافینگ (Keyword Stuffing): این الگوریتم به راحتی صفحاتی که با تکرار غیرطبیعی کلمات سعی در فریب موتور جستجو دارند را شناسایی کرده و ارزش آنها را کاهش میدهد.
جمع بندی
درک اینکه tf-idf چیست به ما نشان میدهد که نوشتن برای وب، از یک فرآیند انشانویسی ساده به یک معماریِ دادهمحور تبدیل شده است. موتورهای جستجوی مدرن به دنبال کشف ارتباطات ریاضی و آماری بین کلمات هستند تا جامعترین و مرتبطترین پاسخ را به کاربر ارائه دهند.
در مجموعه رایاپارس، ما تولید محتوا و استراتژیهای سئو را بر مبنای تحلیلِ ساختاریافتهی دادهها (Data-driven) معماری میکنیم. ما در خدمات سئو به جای تکیه بر روشهای منسوخی نظیر چگالی کلمات، روی پوشش کامل موجودیتها (Entities) و مفاهیم مرتبط تمرکز داریم تا الگوریتمهای پردازش زبان طبیعی، پلتفرم شما را به عنوان جامعترین مرجع بشناسند. همچنین با پیادهسازی این محتوای ساختاریافته روی پلتفرمهایی با طراحی سایت اختصاصی و پشتیبانی از طریق زیرساخت و سرور قدرتمند، اطمینان حاصل میکنیم که محتوای ارزشمند شما با بالاترین سرعت در اختیار خزندههای گوگل و کاربران نهایی قرار گیرد.